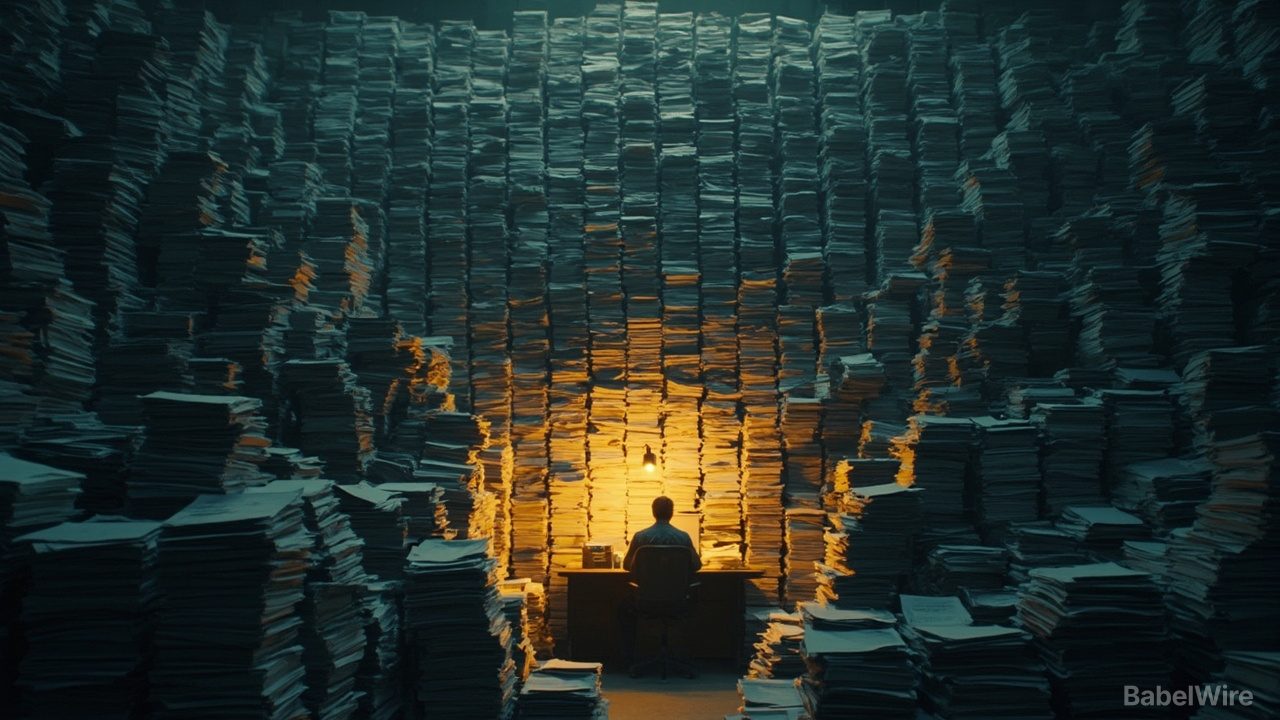
Der Befund der Umfrage
TechCrunch greift eine neue Umfrage auf, deren These allen bekannt vorkommen dürfte, die Menschen führen, die KI-Werkzeuge benutzen: Produktivität wird versprochen, geliefert wird der Kopfschmerz. Führungskräfte, so der Befund, sehen die Zuwächse nicht, die ihnen angekündigt wurden.
Dabei lohnt Präzision. Das heißt nicht, dass die Werkzeuge nicht funktionieren. Es heißt, dass Nutzen und Kosten bei verschiedenen Menschen landen — und die Kosten trägt, wer über die Stellenbudgets verfügt.
Das Erzeugen wurde billig. Das Prüfen nicht.
Die Ökonomie der Wissensarbeit hat sich an genau einer Stelle der Kette verändert. Einen ersten Entwurf zu erzeugen — einen Bericht, eine Funktion, eine juristische Zusammenfassung, eine Marketing-Mail — dauerte Stunden, nun Sekunden. Stromabwärts davon wurde nichts schneller.
Der Entwurf muss weiterhin gelesen, geprüft, korrigiert und verantwortet werden. Diese Arbeit lässt sich nicht parallelisieren, nicht bündeln und wächst linear mit der Zahl der Entwürfe. Je mehr KI ein Team einsetzt, desto mehr der Woche seiner Führungskraft geht in die Prüfung.
In der Software ist das keine neue Beobachtung — es ist die älteste überhaupt. Code-Review war der Engpass, bevor irgendjemand ein Modell auf eine Codebasis richtete, und jede „10x-Entwickler“-Behauptung der Geschichte hat stillschweigend eine Prüfinstanz mit unendlicher Kapazität vorausgesetzt. Neu ist, dass der Engpass die Technik verlassen hat und in Marketing, Rechtsabteilung, Finanzen und Support gewandert ist — Bereiche ohne Review-Kultur und ohne Werkzeuge dafür.
Drei Dinge, die Führungskräfte tatsächlich tragen
Prüfschuld. Fertig wirkende Ergebnisse sind teurer zu kontrollieren als erkennbar rohe, weil die Aufmerksamkeit der prüfenden Person aktiv rekrutiert werden muss. Selbstsichere, sauber formatierte, subtil falsche Arbeit ist der schlimmste Fall — und genau das, was Modelle produzieren.
Unmessbare Ausgangslage. Einen Produktivitätsgewinn kann man nicht behaupten, ohne zu wissen, was die Aufgabe vorher kostete. Die meisten Organisationen haben das nie gemessen, also wird jede KI-Einführung gegen ein Gefühl bewertet.
Unklare Verantwortung. Wenn Mensch und Modell gemeinsam ein Dokument verfassen, teilt sich die Rechenschaft nicht sauber. Führungskräfte verantworten Arbeit, die sie nicht geschrieben haben, nicht vollständig rekonstruieren können und in einer Sitzung womöglich nicht verteidigen.
Das „vorerst“ ist der wichtige Teil
Die Schlagzeile schränkt zu Recht ein. Die Werkzeuge werden besser bei dem, was Prüfung teuer macht: Quellen nennen, Unsicherheit markieren, Diffs statt Dokumente liefern. Zurück bleibt die organisatorische Seite: Niemand hat entschieden, wie viel Prüfzeit eine KI-gestützte Aufgabe verbrauchen darf — also verbraucht sie alles.
Die praktische Antwort ist unspektakulär. Prüfstunden explizit budgetieren, so wie man Build-Zeit budgetiert. KI bevorzugt dort einsetzen, wo Prüfung billig und automatisch ist: Code, der kompiliert und Tests besteht; SQL, das eine plausible Zeilenzahl liefert; Transformationen mit offensichtlicher Prüfsumme. Und nicht Output-Volumen messen, sondern die Nacharbeitsquote: Entscheidend ist, wie viel der erzeugten Arbeit wiederholt werden musste — und von wem.
Nichts davon braucht neue Software. Es braucht das Eingeständnis, dass der Engpass gewandert ist und dass daneben ein Mensch steht.